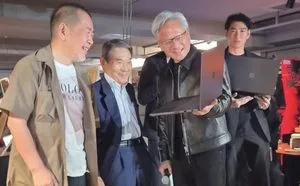

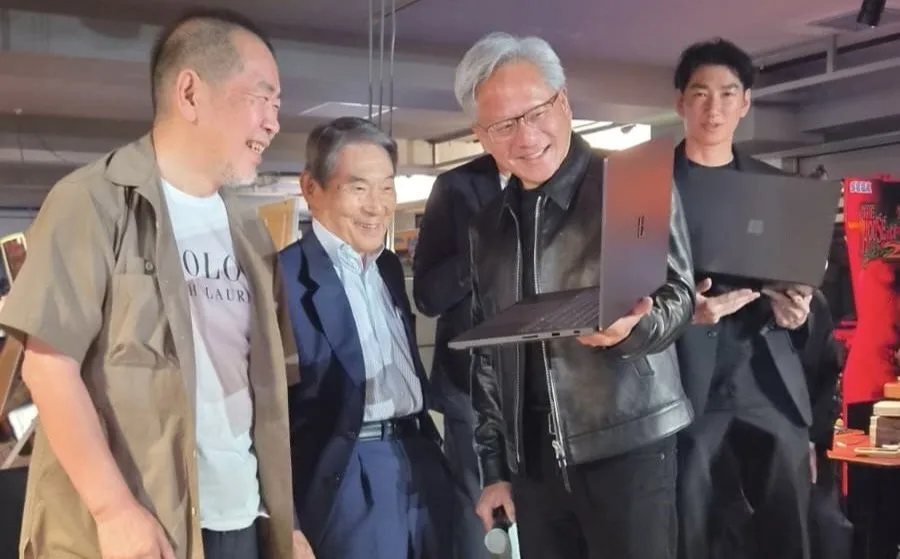
2026年7月15日、東京・秋葉原のゲームセンターに、世界で最も価値のある会社のCEOが立った。NVIDIAのJensen Huang氏である。隣には、30年前、セガの副社長としてこの会社を破産の淵から引き上げ、のちに社長としてドリームキャストを世に送ることになる入交昭一郎氏がいた。壇上でHuang氏は、若い日の自分が入交氏に告げた言葉を振り返っている。
「御社の次のゲーム機に、私たちの技術は使えません」
事の始まりは1995年5月にさかのぼる。セガは設立2年目のNVIDIAと5年間の提携を結び、セガサターンの後継機、のちの「ドリームキャスト」に載せる画像チップ「NV2」の開発を任せた。7月には優先株75万株を500万ドル(約8億円。円換算は2026年8月27日のレート、以下同じ)で引き受け、開発費も1995年に200万ドル、1996年に300万ドルを払っている。相手は年間売上118万ドルの会社である。だがNV2は完成せず、1996年にセガは計画を見直し、NVIDIAは開発を打ち切った。セガが2年で払った金は計1000万ドル(約16億円)。その対価であるはずのチップは、ついに世に出なかった。
その会社の2026年1月期の年間売上は2159億ドル(約34兆円)で、1996年の391万ドルから5万倍を超えた。何が起きたのか。経営の物語としてではなく、チップの中で起きたことを追うと、奇妙な事実に行き当たる。画面に絵を描くために生まれた回路に新しい使い方を持ち込んだのは、いつもNVIDIAの外にいた人たちだった。順に挙げれば、セガ、SGI、スタンフォード大学、東京工業大学、トロント大学、理化学研究所となる。本稿は、この7つの組織を主役に据えた30年史である。
前提として、GPUの性質を簡潔に押さえておく。CPUが何でも順番にこなす1人の秀才だとすれば、GPUは同じ計算だけを一斉にこなす数千人の作業班である。画面は数十万個の画素の集まりで、どの画素にも同じ色計算が要るから、絵を描く回路は生まれつきこの形をしている。覚えておくのは「同じ計算を、大量に、同時に」の一句だけでよい。
3Dも音もジョイスティックも、1枚のチップに
1995年5月22日、NVIDIAは最初の製品「NV1」を発表した。発表文の看板は「PCを究極のマルチメディア機に変える」だった。3D描画、2D描画、動画再生、楽器音を合成する音源、ジョイスティック入力までを1チップに詰め込む欲張りな設計で、PCカード最大手のDiamond Multimediaが「Edge 3D」の名でカードにして小売店に並べた。カードの背面には、なぜかセガサターン用ゲームパッドの端子が付いていた。
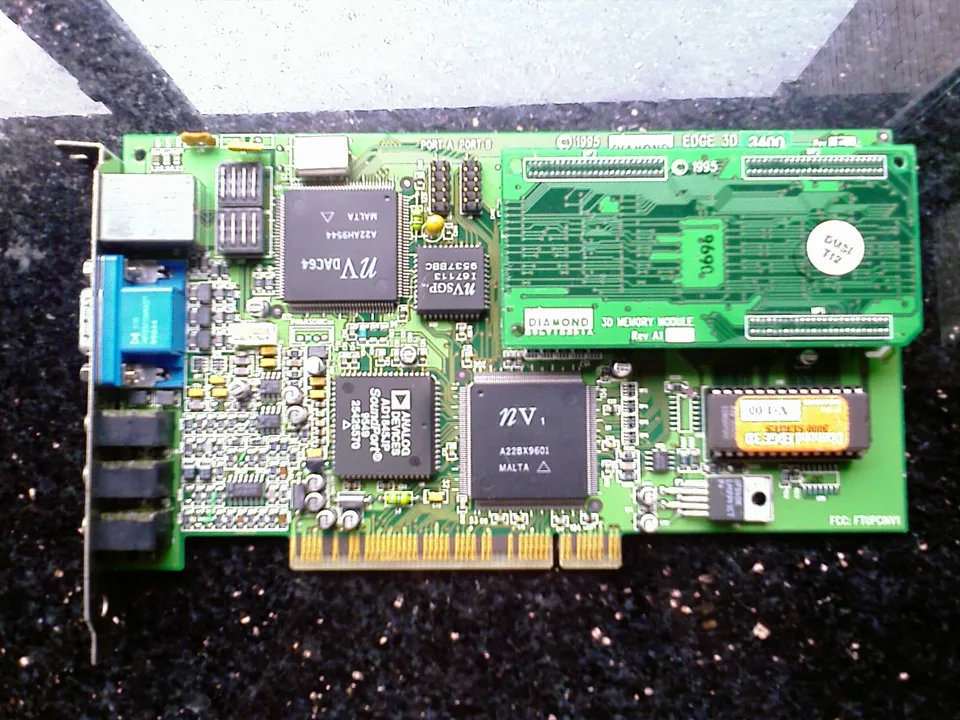
端子の意味は、1995年7月31日のセガ側の発表で分かる。誤解されやすいところなので先に断っておくと、NV1がサターンに載ったのではない。逆に、サターンとアーケードのゲームをNV1搭載PCへ移植する独占契約だった。『バーチャファイター リミックス』や『デイトナUSA』のPC版がNV1向けに出ており、サターンのパッドをEdge 3Dのようなグラッフィックボードに挿して、同じ操作で遊ばせるための端子である。セガのゲームで検証済みの技術を土台に、次世代機NV2の開発契約が重なっていた。
つまずきは技術の根っこにあった。当時の3D業界は、無数の小さな三角形(ポリゴン)で物の形を近似する「ポリゴンレンダリング」へ雪崩を打って向かっていた。NV1は逆張りで、曲面を数式のまま扱う方式に賭けていた。業界アナリストのJon Peddie氏はこれを「quadratic texture mapping(2次曲面方式)」と呼び、主流とは劇的に異なる道だったと記録している。少ないデータで滑らかな曲面を描ける利点はあった。だが1996年末までに業界標準の座についたMicrosoftのDirect3Dも、SGIのワークステーション技術から生まれたOpenGLも、ポリゴンが前提だった。標準を外れた技術の行き着く先は早い。NVIDIAが1998年に米証券取引委員会(SEC)へ提出した上場目論見書は、NV1の販売を1996年第1四半期に止めたと記す。1996年3月4日にDirect3D対応を発表したが、間に合わなかった。
NV2も同じ方式の延長にあった。秋葉原の壇上でHuang氏が語ったのは、その顛末である。開発9か月ほどで、自分たちのフォワードテクスチャマッピングと曲面の技術はドリームキャストでは機能しないと分かった。必要なのは逆方向のテクスチャマッピングとポリゴンだった。それを入交氏に正直に伝えた──。ドリームキャストは別方式のチップで1998年に世に出る。
ここで金の流れを整理しておきたい。本人たちの回想では「開発中止の後、契約金を出資に振り替えてもらった」という順序で語られることが多い。だがSECの記録上、優先株500万ドルの取得は提携直後の1995年7月、つまり失敗が見える前である。順序はどうあれ動かない事実が1つある。チップが来ないと分かった後も、セガは金を引き揚げなかった。NVIDIAの手元には、1995〜1996年の売上合計の2倍にあたる資金が残り、それが次のチップの開発費になった。
しかもこの話は、セガが泣いただけの美談では終わらない。米誌Inc.の取材にセガが答えたところによれば、セガは1999年のNVIDIA上場後、保有していた株式を約1500万ドルで売却している。500万ドルの出資は、4年で3倍になって戻った勘定になる。開発費の500万ドルは製品という形では返らなかったが、救った会社の株が埋め合わせた。セガと入交氏がいなければ今日のNVIDIAは存在しなかっただろう、という壇上のHuang氏の言葉は、両社の帳簿が裏書きしている。
ワークステーションの技術がPCのカードに降りる
セガの資金で息をつないだNVIDIAは、次の製品であっさり転向する。1997年8月の「RIVA 128」はポリゴンとDirect3Dに全面対応し、1997年の売上は実質すべてこの1チップが稼いだ。同じ年の第4四半期、創業から4年半で初めての黒字が出る。1998年1月12日の発表文は出荷100万個を告げ、Peddie氏は高性能セグメント600万台の推計21%を4か月で取ったと評した。Huang氏が掲げた言葉は「3Dを大衆へ」である。
だが、大衆に降りてきたその3Dは、どこで生まれた技術だったのか。答えの一端は、3か月後に届いた1通の訴状が教えてくれる。
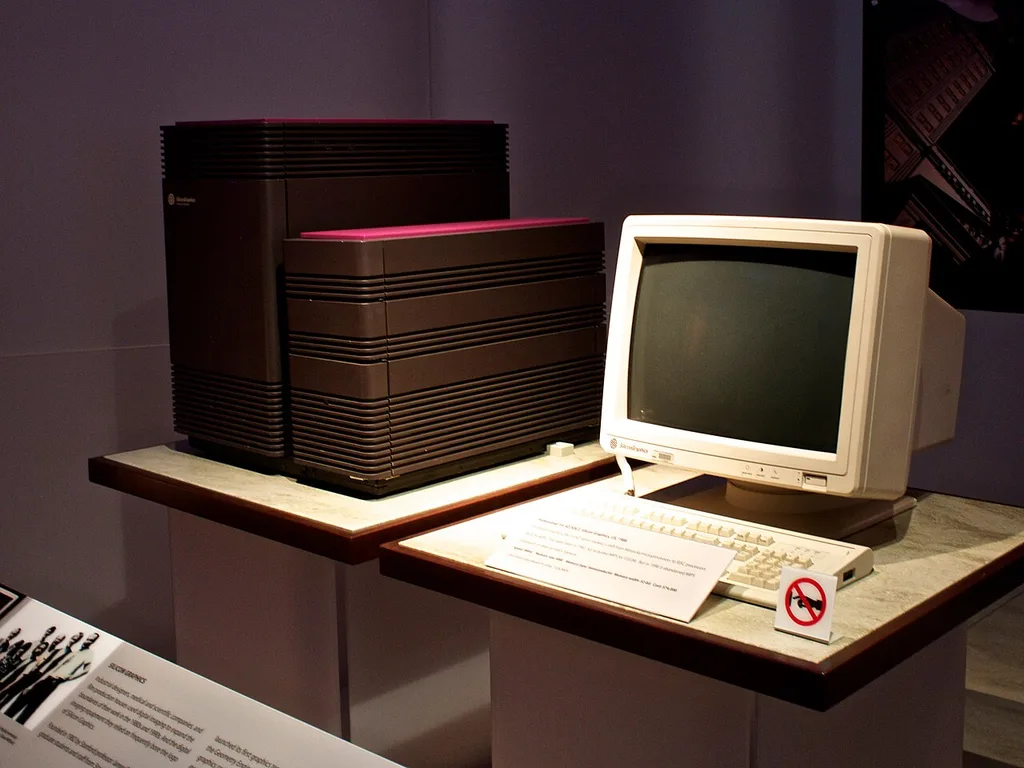
差出人はSGI(Silicon Graphics)。1990年代、映画のCGや科学の可視化に使われる数百万円から数億円級の高性能計算機「ワークステーション」の頂点にいた会社である。SGIが1993年の学会で発表した描画装置「RealityEngine」は、最大構成で353個のプロセッサーを束ね、毎秒2億4000万画素を描画し、100万枚を超える三角形を処理した。論文が挙げる用途は、操縦訓練装置の窓の外の景色を途切れなく作り続けるような仕事である。PCゲーマーが1997年に手にした3Dを、SGIは桁違いの価格帯でひと足先に作っていた。特許は、その開発の副産物として積み上がっていた。
SGIが持ち出した米国特許5706481号の主題は「テクスチャマッピング」である。白い箱の表面に木目の写真を貼れば、木の箱に見える。3Dの世界で物体の表面に画像を貼り付けるこの処理の名前である。画面の1点ごとに元画像を参照するので計算が重く、特許は画像用メモリーと参照回路を1チップにまとめ、安価な機器でも高速に処理する方法を主張していた。発明者の筆頭格はSGI共同創業者のMarc Hannah氏で、特許の成立は提訴のわずか3か月前、1998年1月6日だった。NVIDIAは提訴の通知を受けたその日のうちに反論声明を出し、裁判は1999年7月、和解と戦略提携で終わる。
もう1社、当時のゲーマーなら誰もが知っていた相手がいる。3dfxである。元SGIの技術者3人が1994年に飛び出して作った会社で、米コンピューター歴史博物館は「Voodoo GraphicsでPCの3D時代を代表する製品を作り、業界の頂点からわずか数年で破産に至った」と収蔵解説に書く。1996年発売のVoodooは3D専用カードとしてPCゲーマーの熱狂を集め、1990年代後半のNVIDIA最大の壁だった。その3dfxが1998年9月、1つの面に複数の画像を重ねて貼るマルチテクスチャリングの特許でNVIDIAを提訴する。標的の「RIVA TNT」は、3月の発表文によれば約700万トランジスタ、1クロックに2画素、毎秒2億5000万画素を描画する。Pentium II並みの規模の回路が、絵のためだけに使われる時代が来ていた。353個のプロセッサーでRealityEngineが出した数字は、5年後には1個のチップに抜かれている。
2つの裁判の決着をつけたのは、判決ではなく市場だった。3dfxは2000年12月に自社資産をNVIDIAへ売る契約を結び、SECへの報告によれば2001年4月の取引完了時に現金5500万ドル(約88億円)を受け取り、2002年に破産した。SGIも2009年4月1日に連邦破産法11条を申請し、同じ日に資産を約2500万ドルで売却する契約を結んでいる。ワークステーションで3Dを開拓した会社も、PCで3Dを開拓した会社も残らず、その領域はNVIDIAのチップが埋めた。
「GPU」と名乗った日
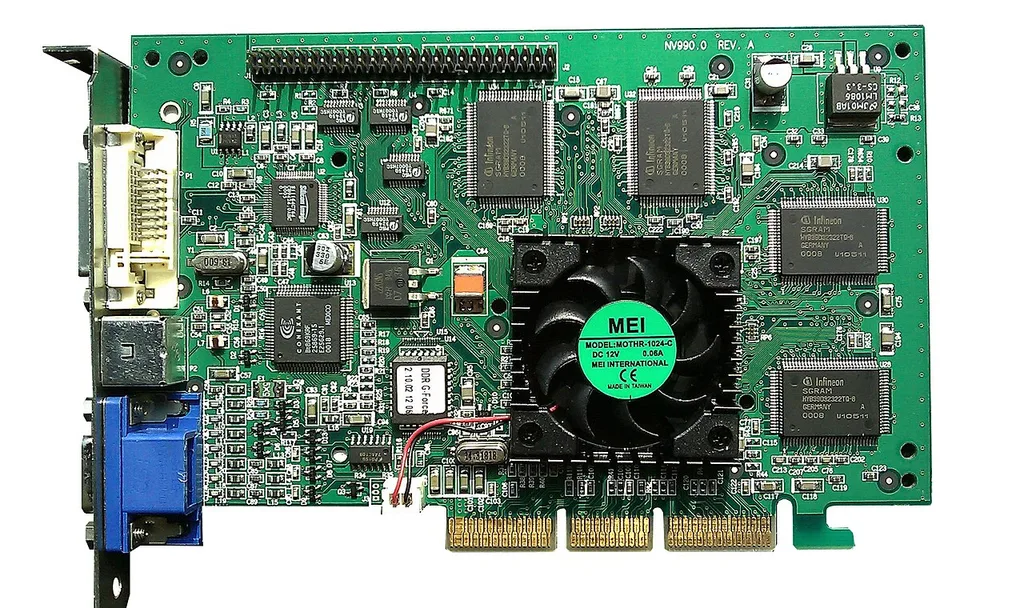
1999年8月31日、NVIDIAは新製品「GeForce 256」に、「世界初のGPU」という聞き慣れない肩書きを付けて発表した。プレスリリースにはその定義まで自ら書いている。座標を変換するエンジンと、光の当たり方を計算するエンジンと、256ビットの3Dプロセッサーと、4本の画素処理パイプラインを1チップに集積したもの。約2300万トランジスタ、毎秒1500万枚の三角形、毎秒4億8000万画素の描画性能という数字が並ぶ。
定義に並ぶ言葉は、3D映像が画面に表示されるまでの3つの工程を追うと読み解ける。第1段階「変換」は、三角形の頂点の位置を3次元空間の座標から画面の2次元座標へ計算し直す作業で、視点が動けば毎コマやり直す。第2段階「照明」は、光源と面の向きから明るさを求める。第3段階「描画」は、三角形を画素に分解し、テクスチャを貼り、色を確定する。それまでのカードは第3段階しか受け持たず、変換と照明はCPUの仕事だった。CPUが下書きを終えるまでカードは待つ。GeForce 256は変換と照明の回路を自前で載せ、3段階を通しで引き受けた。発表文の2つの「エンジン」はこれを指す。
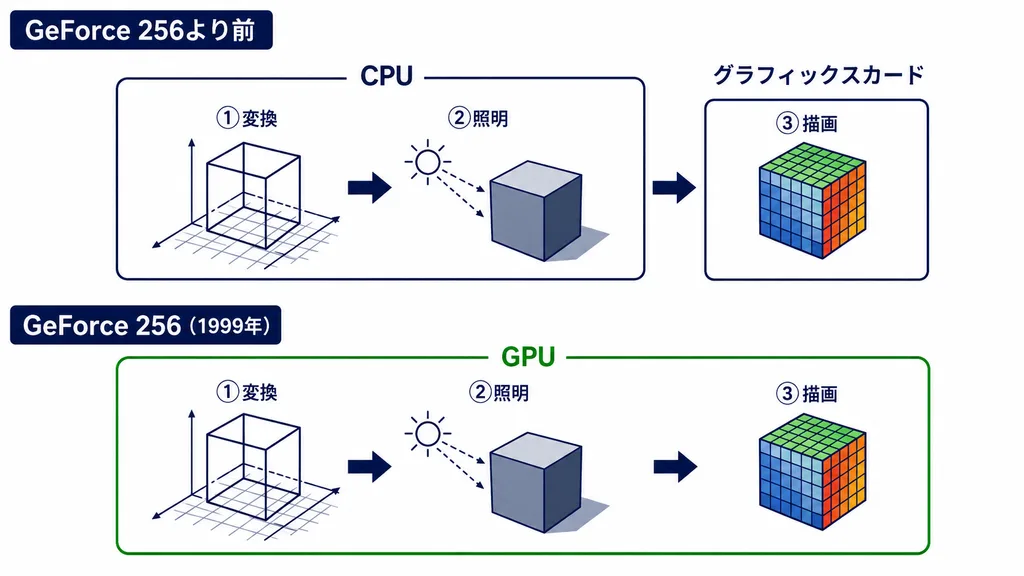
GeForce 256は3工程すべてをチップに載せた(図:編集部が生成AIで作成)。
ただし、この時点の3段階は固定回路である。変換の式も照明の式もチップに焼き付いていて、ゲームの作り手には変えられない。工場にたとえれば、各工程の作業は決まっていて、流す部品を替えることしかできない。転機は2001年2月の「GeForce3」で来た。頂点の処理と画素の処理に、ゲーム開発者が独自の手順を書き込めるようになったのである。工場の各工程に、作業者が読む手順書を差し込めるようになった、と言い換えてもいい。NVIDIAはこれを「業界初のプログラマブルGPU」と呼んだ。手順書に書くのは本来、色や明るさの計算だった。だが、手順書を読める作業班が世界中のPCに広がれば、絵と関係のない手順書を書く人間が現れる。
研究者が絵を描かずにGPUを使い始めた
絵と関係のない手順書を最初に書いたのは、大学院生たちだった。2000年代前半、ノースカロライナ大学チャペルヒル校(University of North Carolina at Chapel Hill)の博士課程にいたMark Harris氏は、GPUに雲の動きを計算させる研究をしていた。雲のシミュレーションは、空を細かい格子に切り、各点の気流や水分に同じ計算を繰り返す仕事である。冒頭に掲げた「同じ計算を、大量に、同時に」と、そっくり同じ形をしている。研究者たちは数値データを画像のふりをしてGPUに渡し、シェーダー(前章の手順書)に計算式を書き、描き上がった「絵」から答えを読み出す離れ業で、絵を描く回路に科学計算を解かせ始めた。Harris氏はこの潮流に名前をつけた人物として、NVIDIAの公式ページに紹介されている。その名は「GPGPU」、GPUによる汎用計算という意味である。
「絵を描くふり」を不要にする道具も、大学から出た。2004年、スタンフォード大学(Stanford University)のIan Buck氏らが発表した「Brook for GPUs」は、画像処理の用語を知らなくても、データの流れとして計算を書けばGPUで走る言語だった。そしてHarris氏は2003年に、Buck氏も後にNVIDIAへ移る。大学で生まれた発想が、人ごと会社に吸い込まれていった。
NVIDIAはこの発想を、製品の設計思想ごと取り込む。2007年2月に公開した「CUDA」は、GPUの並列計算を標準的なC言語から使えるようにする開発環境である。プログラマーは、何百万件のデータに適用したい計算を1つの関数として書く。CUDAがそれを何千という処理単位に分け、GPUに並ぶ数百の計算器へ同時に流し込む。絵を描くふりも、シェーダーの知識も要らない。対応第1世代の「GeForce 8800」からは、頂点用と画素用に分かれていた回路も、どちらもこなす同じ作りの計算器群に改められた。決まった絵作りを超高速にこなす専用機だったGPUは、ここから並列計算機として設計されるようになる。
この決断の代価は大きかった。CUDAの回路はゲーマーには無用の長物だが、Huang氏はゲーム用を含む全製品に載せた。年次報告書を見ると、粗利益率は2008年1月期の45.6%から翌年34.3%へ沈む(報告書自体は主因として製品の材料不良に伴う1億9600万ドルの保証費用を挙げており、CUDAだけのせいではない)。株価は2007年秋の高値39.67ドルから2008年11月には5.75ドルまで、85%落ちた。Huang氏は2026年3月のインタビューで、CUDAが消費者向け製品のコストを押し上げて粗利益を食い尽くし、回復に10年かかったと振り返り、それでも判断の理由を「インストールベースがアーキテクチャを定義する。他はすべて二の次だ」と言い切っている。使うあてのない計算機能を積んだゲーム用カードが、こうして世界中に散らばった。
ゲーマーのPCが科学の計算機になる
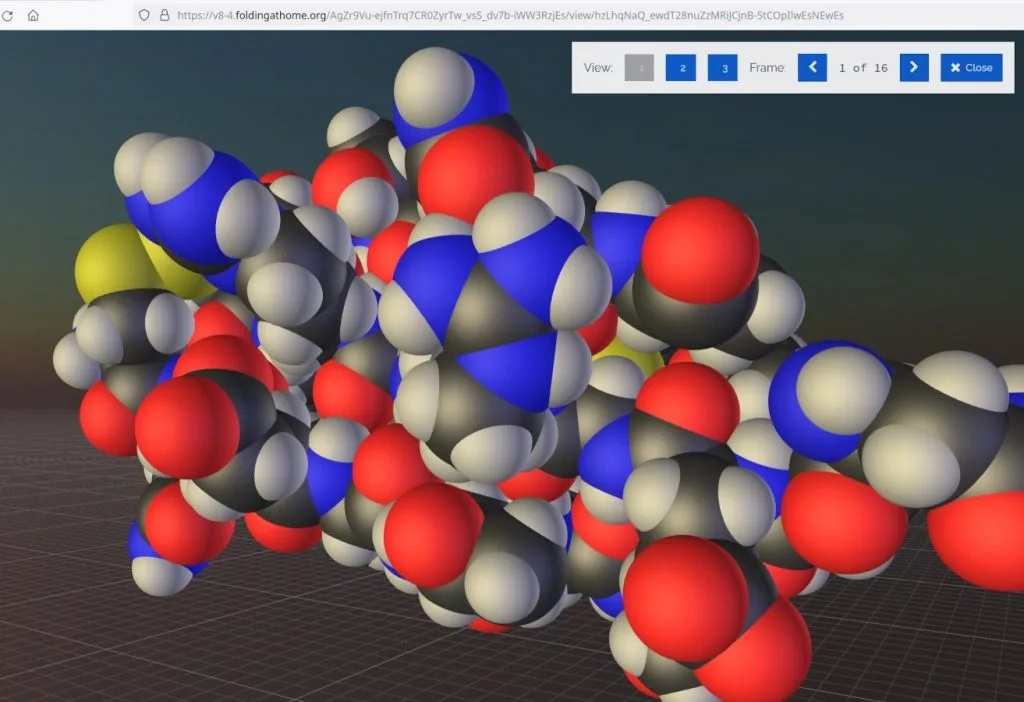
世界中のPCに散らばったこの計算力に最初に目をつけた科学者は、実はゲーム業界の出身だった。スタンフォード大学のVijay Pande氏である。本人の経歴によれば、10代でゲーム会社Naughty Dogの3人目の社員として働いた経験を持つ化学者である。Pande氏が2000年に始めた「Folding@home」は、病気に関わるタンパク質の折りたたみを、世界中の志願者のPCが空き時間に少しずつ計算する分散コンピューティングのプロジェクトだった。1台の巨大なスーパーコンピューターを建てる代わりに、巨大な計算を細かく割って善意の何十万台に配る。参加者が差し出すのは計算力と電気代で、見返りは科学への貢献だけである。
このプロジェクトが2006年10月、GPUで動く計算クライアントを出した。コアはBrook言語で書かれていた。スタンフォードで生まれた言語が、同じ大学のプロジェクトを支えた格好である。高性能なカードを持つ参加者、つまりゲーマーの1台が、普通のPCの何十台分もの戦力になった。
そしてゲーム機そのものが合流する。2007年3月、ソニー・コンピュータエンタテインメントがPLAYSTATION 3にFolding@homeの公式アプリを載せたのである。居間のゲーム機が、電源を入れたまま夜通しタンパク質を折る。参加は爆発的に増え、SCEの発表によれば2008年2月には登録100万台を超え、プロジェクト全体の計算力の約74%をPS3が担った。2007年9月16日にはプロジェクト全体で毎秒1000兆回計算のペタフロップスを突破し、分散コンピューティングとして史上初のギネス世界記録に認定される。ゲーマーとゲーム機の善意が、束になって国家級の計算力を生んだ。プロジェクトの年表によれば、新型コロナウイルスの解析に参加が殺到した2020年には約1.5エクサフロップスに達し、世界初のエクサ級計算システムを名乗るまでになる。
同じころ日本では、一人の研究者が逆の賭けをしていた。善意の分散ではなく、GPUを1か所に集めて国のスパコンにする賭けである。東京工業大学(現・東京科学大学)の松岡聡氏は2008年11月、スーパーコンピューター「TSUBAME」にNVIDIAのTesla S1070を170台、GPU680基を組み込んだ。大学のプレスリリースに松岡氏は、システムを止めずに2週間で作業を終え、実測性能が77.48テラフロップスへ倍増したと語っている。世界のスパコン番付Top500の2008年11月版では29位に入った。
HPC専門誌のHPCwireはこれをGPUで動くスーパーコンピューターがTop500に入った最初の例と評した。ゲーム用と同じ設計のチップが、国の研究基盤に入った瞬間である。教壇にも同じ言語が届いていた。NVIDIAは2008年6月、イリノイ大学アーバナ・シャンペーン校(University of Illinois Urbana-Champaign)を世界初の「CUDA Center of Excellence」に指定し、2年後の年次報告書には、世界の300以上の大学がCUDAで並列プログラミングを教えているとある。ゲーム用カード2枚が人工知能に火をつけた。
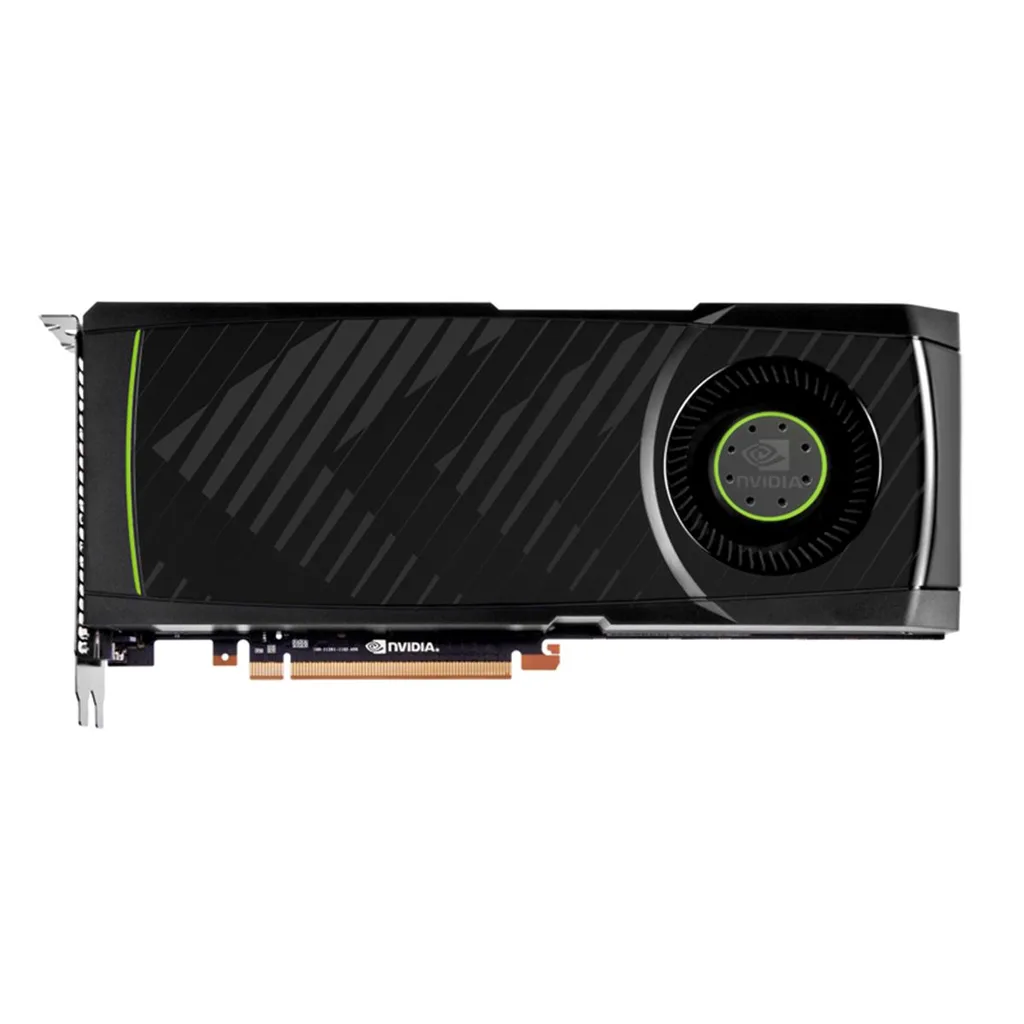
2012年秋、画像認識の世界的コンテストILSVRCで、トロント大学(University of Toronto)のチームが2位以下を突き放して優勝した。率いたのは、人工知能の世界で長く傍流扱いだったニューラルネットワーク研究を続けてきたGeoffrey Hinton氏である。手を動かしたのは研究室の院生2人で、ネットワークを設計したAlex Krizhevsky氏と、のちにOpenAIを共同創業するIlya Sutskever氏である。3人の論文の機材欄には、GTX 580を2枚使い、学習に5日から6日かけたとある。GTX 580は、ゲーマー向けに市販されていたカードである。研究室の予算で買える2枚の板が、後にAlexNetと呼ばれ人工知能ブームの引き金を引いた。
なぜGPUだったのかは、もう説明が要らないはずである。使われた畳み込みニューラルネットワークは、画像の小さな領域に同じ計算を何百万回も繰り返す手法で、その実体は巨大な行列のかけ算、つまり「同じ計算を、大量に、同時に」である。雲のシミュレーションと同じで、この形の仕事はGPUの生まれつきの得意技だった。
NVIDIA側も、外から扉を叩かれて気づいた。当時の主任科学者Bill Dally氏はスタンフォード大学のAndrew Ng氏と朝食の席で会い、Googleが1万6000個のCPUを使っていた画像認識の研究をGPUで置き換えようと持ちかけたと、NVIDIAの公式ブログで語っている。NVIDIA ResearchのBryan Catanzaro氏がNg研と組んだ2013年の論文は、3台の機械で10億パラメーターのネットワークを数日で学習できると示した。ブログはこれをGPU12基で2000個のCPU相当と要約する。以降のNVIDIAは、汎用に広げた回路をもう一度AI専用へ絞り込んでいく。2014年にニューラルネットワーク用ライブラリ「cuDNN」、2017年には行列のかけ算だけに特化したTensorコアを640個積んだ「Tesla V100」。深層学習でCPU100個分をうたう回路である。
AIより先に割り込んだ使い手にも触れておく。仮想通貨の採掘、マイニングである。ゲーマーが買えなくなるほどカードが採掘に回った時期があり、米SECは2022年5月、NVIDIAが2018年1月期の2四半期でマイニング需要の寄与を開示しなかったとして550万ドルの制裁金で和解したと発表した。採掘需要は、2022年9月にEthereumが計算量に頼らない方式へ移行して消える。用途は勝手に来て、勝手に去ることもある。
手のひらのAIと、国家のスパコン
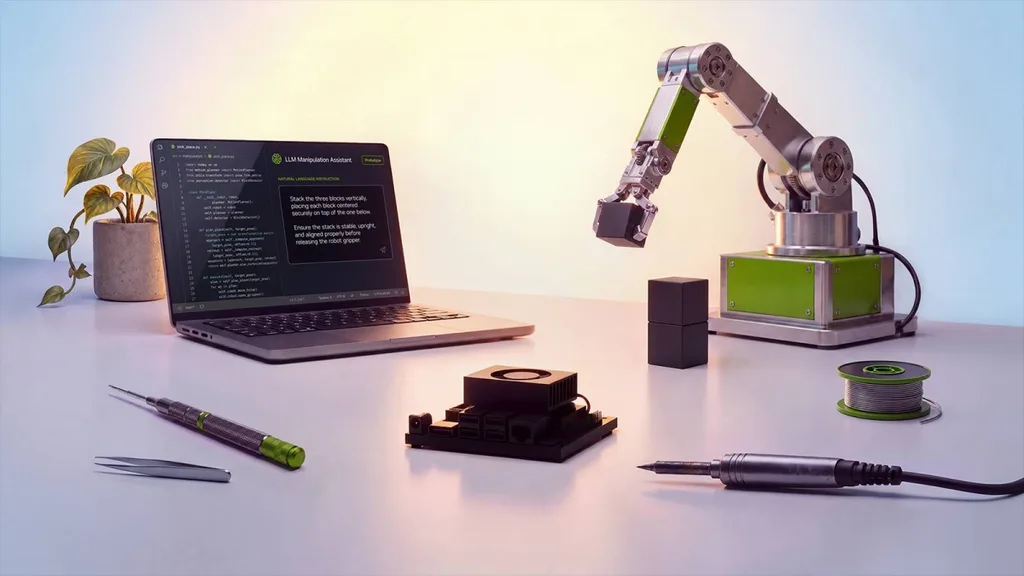
NV1から数えて30年、GPUは両極端の場所へ同時に向かっている。一方の極は、机の上に置ける小さな専用機である。2019年3月、NVIDIAは組み込み開発者と研究者、DIYのMakerに向けて99ドル(約1万6000円)の「Jetson Nano」を出した。128個のGPUコアを載せた小型ボードだが、グラフィックスカードではない。ロボットやカメラに組み込み、その場でAIを走らせるエッジAIコンピューターである。思えば、NVIDIA共同創業者のCurtis Priem氏が1984年にIBM向けに設計した拡張ボード「Professional Graphics Controller」は、IBMの技術資料によれば640×480ドット・256色の絵を描くためだけに専用の8088プロセッサーを積んでいた。35年をへだてて机の上に戻ってきた専用計算機は、絵ではなくAIを動かすためにある。ただし「個人の道具」と言い切れるかは、いまや怪しい。AI需要でGPUの価格は高止まりし、2026年8月25日に発表された後継の「Jetson Orin Nano 2」(毎秒78兆回演算、2027年前半出荷)は価格未発表のまま、採用例に並ぶのは産業用カメラや建機、配送ドローンの企業ばかりである。個人の側へ降りてきた回路が、また企業へ引き上げられていく気配も、この系譜には混じっている。
個人の側、とりわけオープンソースのコミュニティとの間には、長い確執もあった。2006年、NVIDIAのソフトウェア製品マネージャーAndrew Fear氏は「顧客はオープンソースのドライバを求めていない」と述べた。仕様書のないNVIDIA製GPUを解析し、有志でドライバを作っていた「Nouveau」プロジェクトのStéphane Marchesin氏は、2007年の講演スライドの最後にこの発言を掲げている。2012年にはLinuxの生みの親Linus Torvalds氏がアールト大学の講演で、NVIDIAを「これまで相手にした中で最悪の会社」と呼んだ。それが2022年5月、NVIDIAはLinuxのGPUカーネルモジュールをGPLとMITの二重ライセンスで公開する。16年かけて、扉は内側から開いた。
もう片方の極は国家である。2025年11月17日、NVIDIAは理化学研究所が2つの新スーパーコンピューターにGB200 NVL4を導入すると発表した。AI向け1600基、量子計算向け540基、計2140基のBlackwell GPUで、2026年春に動き出す。発表文でコメントしているのは理研計算科学研究センター長の松岡聡氏──2008年にTSUBAMEへGPUを載せた、あの松岡氏である。18年前に大学のスパコンで試した賭けを、いまは国の次期フラッグシップ「FugakuNEXT」(富士通のCPUとNVIDIAのGPUを新技術「NVLink Fusion」で直結、2030年ごろ稼働目標)の準備として、国家の規模でやり直している。発表文には、AI向けのTensorコアを物理や気象の計算に生かす浮動小数点エミュレーションを理研と共同開発中ともある。AI専用に絞った回路を、科学計算へ使い直す。用途の往復は今も続いている。
決算書から消えた「ゲーム」
2026年8月26日にNVIDIAがSECへ提出した決算発表は、四半期売上962億ドル(約15兆円)、うちデータセンター向け890億ドル(約14兆円)と告げた。全体の92%である。PC向けのRTX、車載、ロボット向けJetsonは「Edge Computing」の1区分にまとめられ、72億ドルだった。文書のどこにも「Gaming」の売上区分はもうない。画面に絵を描くチップで立った会社の決算から、ゲームという項目が消えた。同じ文書には、日本の政府・産業界と国家AIインフラを立ち上げたとあり、次四半期の見通しは中国向けデータセンター売上をゼロと置いて示されている。1998年に「3Dを大衆へ」と書いた男は、この文書で「いまや計算力が収益だ」と書いた。
30年を並べ直すと、GPUに新しい用途を持ち込んだ顔ぶれが浮かぶ。曲面に賭けて散った後も金を引き揚げなかった入交氏がいた。雲を計算していた院生のHarris氏がいて、ゲーム会社出身の化学者Pande氏には、PS3を差し出した100万人の参加者が続いた。TSUBAMEと理研で2度賭けた松岡氏がいて、ゲーム用カード2枚で歴史を変えたトロントの院生たちがいた。どの用途も、NVIDIAの発案ではない。NVIDIA自身が一貫してやったのは、持ち込まれた用途を受け止められる場所を守ることだった。使われるあてのない計算機能を全製品に積み、粗利益を削ってでもCUDAの通じる機械を世界中に増やす。「インストールベースがアーキテクチャを定義する」という言葉は、その30年の要約である。
「同じ計算を、大量に、同時に」という回路の性質は、1995年のNV1から2026年のBlackwellまで変わっていない。変わり続けたのは、その性質に仕事を見つける側だった。ならば次の用途を持ち込むのも、おそらくNVIDIAの外の誰かである。過去30年の記録は、それを繰り返し示している。