
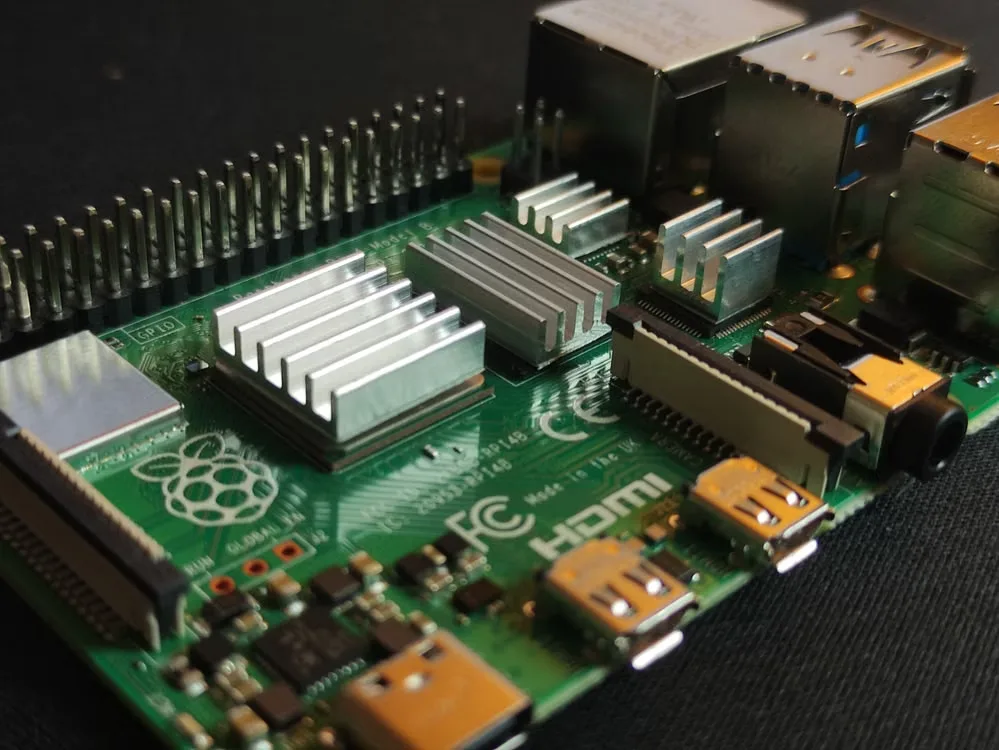
ラズパイに画像を判定させると、思ったほど速くない。そこで使われるのが推論エンジンと呼ばれるソフトウェアで、学習済みのモデルを効率よく動かす役目を負う。ONNX Runtimeやncnnがその代表格だが、モデルが十分に小さいと効き目が薄れる。Avaflyと名乗る開発者は、Fashion-MNISTを認識する小さなCNNをCで書き起こし、Raspberry Pi 4Bでncnnの約2.9倍、ONNX Runtimeの約3.1倍の速度を出した。コードはMITライセンスでGitHubに公開されている。
効き目が薄れる理由を、同氏は最適化の向き先の違いに求める。細長く平たい行列積や、チャンネル数の少ない畳み込みは、大きなモデル向けの工夫が効かない領域だ。そのうえエンジンはどんなモデルでも動く必要があるため、汎用性と引き換えに速度を手放している。実際の製品では動かすハードウェアもモデル構造も決まっており、モデルが小さければ手書きの手間もたかが知れている、というのが出発点になる。
測定は7万枚の画像を1回で認識させ、ウォームアップ後に複数回走らせて最速値を取る。比較対象のONNX Runtimeとncnnは既定値ではなく設定を詰めてあり、ncnnはスレッドごとに専用のメモリー管理を与えてfp16とパック処理を切り、ONNX Runtimeは最速の入力形状を選んでグラフ最適化を有効にしている。詰めた状態での結果が2440msと2302msで、これが基準線になった。
そこからの改善は4段階だ。古典的なim2colと行列積で組んだ素朴な実装が2116ms、モデル構造を定数として埋め込みコンパイラーに最適化させて1736ms、NEONで書き直して1045ms、演算を融合して783msに縮んだ。
面白いのは3段階目の入り方で、同氏は層ごとに理論限界を計算してから手を付けている。128ビットのNEON命令は1回で4つの積和を処理し、Cortex-A72は1サイクルに1命令を出せる。1枚あたり56448回の積和が必要な最初の畳み込み層なら、7万枚を4スレッド・1.8GHzで処理する限界は137msと決まる。ここに実測を並べると、im2colに291ms、行列積に355msかかっていた。大きなモデルではデータの並べ替えは計算より軽いのに、この規模では全体の3分の1を占めていた。そこで重みをあらかじめ並べ替える形に変え、行列積も自作してim2col自体を消した。
最後の融合では、活性化と最大プーリングの順序を入れ替えている。漏れのある正規化線形関数と最大値の計算は順序を交換しても結果が変わらないため、先にプーリングすれば活性化の対象は4分の1になる。さらに畳み込みと2×2のプーリングと活性化を1つの処理にまとめ、畳み込みの結果をメモリーに書かずレジスターの中でプーリングまで済ませた。活性化をプーリング後の別処理として回すと220msかかるが、レジスター上で済ませれば14msだったという。
各段階の変更は数十行、全体でも数百行に収まる。同氏は行列積の最適化だけを扱った別のリポジトリも公開しており、そちらはRaspberry Pi 4BのCPUだけで220倍の高速化を記録している。