
芝浦工業大学の尾崎克久教授らが考案した計算手法「Ozaki Scheme II(尾崎スキームII)」が、米NVIDIAのGPU向け開発基盤「CUDA」に採用された。2026年9月に公開された「CUDA Toolkit 13.4」に組み込まれ、AI向けに強化されたGPUの演算回路を使って、科学計算に欠かせない倍精度(FP64)の行列計算を高速にこなす。同大学が2026年9月30日に発表した。
気象予測や耐震設計、新材料の開発といった科学シミュレーションでは、数値の桁数を多く扱う倍精度の計算が精度を支える。一方、近年のGPUはAIの学習や推論に向けて、桁数の少ない低精度の計算を優先して速くしてきた。同大学は、NVIDIAのB200の倍精度性能が約40TFLOPS(TFLOPSは1秒あたり1兆回の計算)なのに対し、後継のB300では1.2~1.3TFLOPSと30分の1以下に下がったと、理化学研究所の松岡聡計算科学研究センター長の論文(査読前)を引いて説明している。
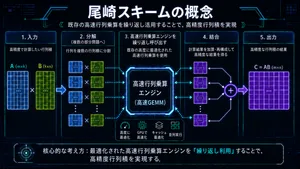
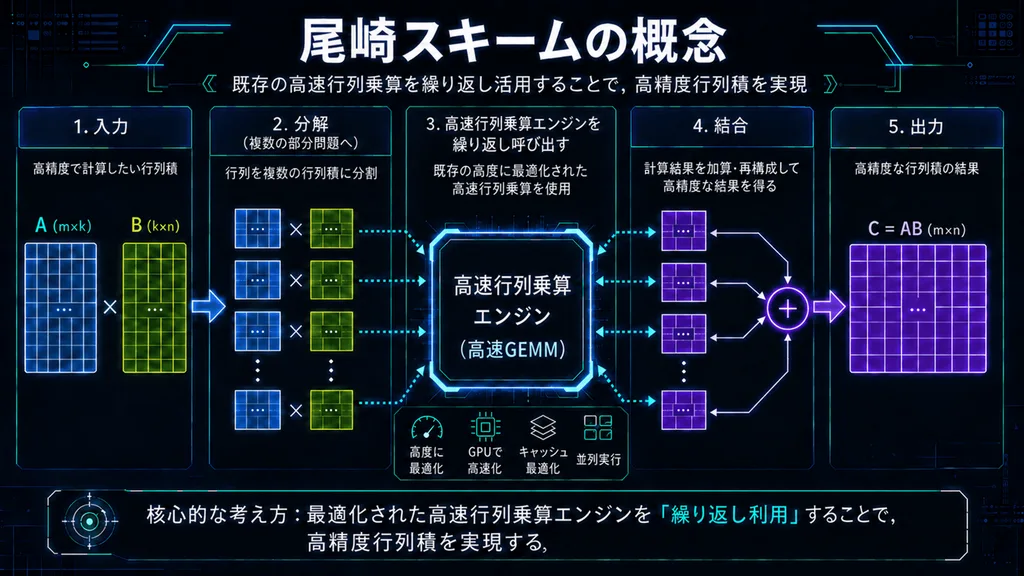
尾崎スキームは、倍精度の行列計算を複数の低精度の計算に分け、数学的に誤差が出ない形で組み合わせ直して、倍精度と同じ精度の答えを得る。新たな回路を足すのではなく、既存のGPU上でソフトウェアとして動くため、倍精度の計算だけでは使われずに遊んでいたAI用の演算器を科学計算に回せる。2012年に発表した初代のOzaki Scheme Iは、2025年にCUDAの行列計算ライブラリへ組み込まれている。今回のOzaki Scheme IIは、整数の余りを使う中国剰余定理に基づく別の原理の方式で、尾崎教授が理化学研究所の内野佑基氏、今村俊幸氏と共同で開発した。
NVIDIAのリリースノートによると、CUDA 13.4ではOzaki Scheme IとIIのうち速い方を自動で選び、IIはAmpere世代以降のGPUで使える。B200では倍精度の行列積が最大175TFLOPSに達し、次世代のRubinでは最大212TFLOPSになるという。同社は、この計算方式が性能と電力効率の両方を改善するとしている。
理化学研究所は2026年3月に公開したスーパーコンピューター「富岳NEXT」の開発状況資料で、数値計算ライブラリの方向性の1つにこの技術による低精度演算器の活用を挙げた。富岳NEXTは富岳の後継機で、2030年ごろの稼働を目指している。
現在の対象は、シミュレーションの中心となる行列の掛け算だ。同大学によると、NVIDIAは連立方程式や固有値計算を扱う上位のライブラリにも同じ仕組みを入れ始めている。Ozaki Scheme IIの論文は2026年7月28日、学術誌The International Journal of High Performance Computing Applicationsに掲載された。