
韓国の半導体大手SK hynixと、米シリコンバレーのTetraMemが、メモリの中でAIの計算を直接こなす省エネなチップを共同で実証した。データをためる部品と計算する部品の間でのやり取りを減らし、消費電力と処理の詰まりを抑えることを狙う。成果は学術誌Advanced Intelligent Systemsに掲載され、表紙にも選ばれた。
いまのコンピューターは、データをためるメモリと、計算する演算部が分かれている。AIは膨大な数の数値、いわゆる重みを扱うため、その間でデータを何度も往復させる必要があり、この行き来が電力と時間の大きな無駄になっている。とくにAIでは、やり取りするデータの量が桁違いに大きい。データセンターの電力が膨らむAIの時代には、とりわけ重い足かせだ。
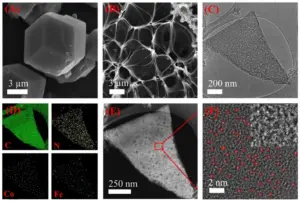
今回の方式は、計算をメモリの外へ運ばず、AIモデルの重みが置かれた場所でそのままこなす。鍵となるのは、抵抗の値を何段階にも設定できる記憶素子、メムリスタ(RRAM)だ。重みを抵抗として書き込み、電気の法則を使って、掛け算と足し算をアナログのまま一度にこなす。データの行き来が減り、効率が上がる。多くの計算をアナログのまま一度に片づけられるため、数字を一つずつ処理するより速く、電力も少なくて済む。こうした方式は研究段階のものが多く、今回は実際に動くチップとして示した点に意味がある。
試作したSoC(機能を一つのチップにまとめた集積回路)は、多くのAI推論モデルで使われる「深さ方向の畳み込み」という計算を効率よくこなした。TetraMemのGlenn Ge氏は、AIの進化には、計算だけでなくメモリやシステム全体の設計の革新も要ると述べる。メモリを主力とするSK hynixが計算の側へ踏み込む形で、記憶と計算の境目は揺らぎつつある。増え続けるAIの電力と発熱への対策として、メモリを中心に据えた計算が、重みを増していきそうだ。