
ESP32で小さな機械学習モデルを動かすとき、フラッシュとRAMを食うのはモデル本体だけではない。モデルの計算グラフを解釈して動かすランタイム、TensorFlow Lite Microが一緒に載る。PHPLegoと名乗る開発者は、そのランタイムを取り除く道具「NN2Prog」を作り、Apache-2.0ライセンスで公開した。
やっていることは変換だ。.tfliteファイルを埋め込んでマイコン側で解釈させるのではなく、ビルドの段階でモデルを解析し、計算そのものと定数をC++17のコードとして書き出す。できあがったファームウェアはTFLite Microをリンクしない。
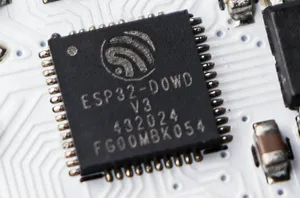
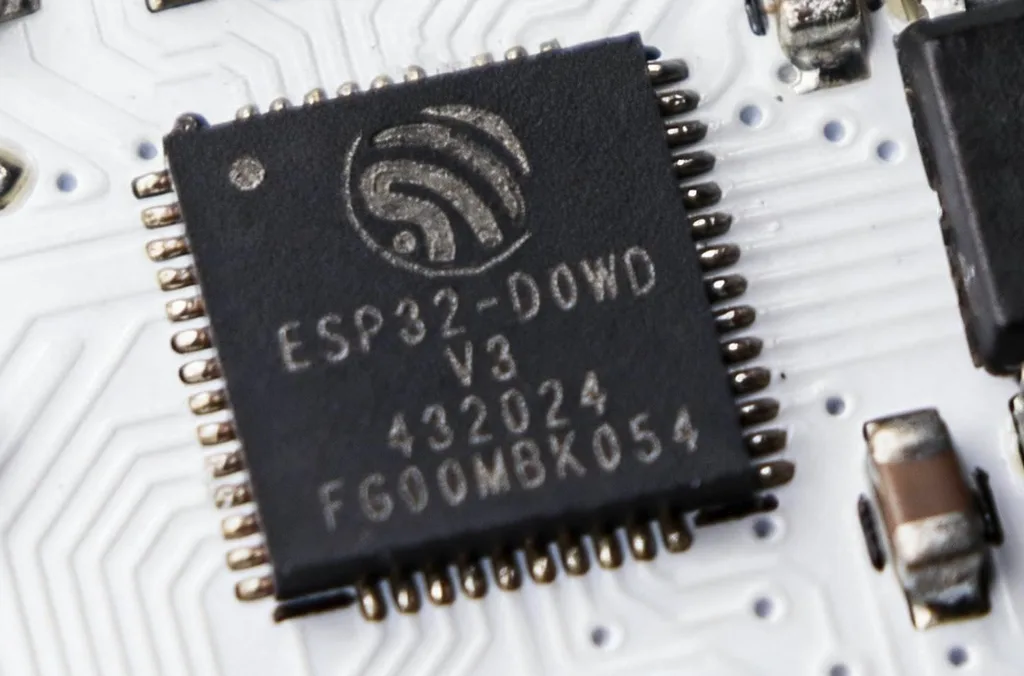
効果を数字で示している。ベンチマークにはMLPerf Tinyのキーワード検出モデルを使い、240MHzで動かしたESP32-D0WD-V3で測った。TFLite MicroにESP-NNを組み合わせた場合と比べ、フラッシュの使用量は28万7039バイトから18万5915バイトへ35.2%減り、動作中に使うメモリーは2万2780バイトから1万6000バイトへ29.8%減った。推論にかかる時間も161.72ミリ秒から140.30ミリ秒へ13.2%縮んだ。
数字の出し方も明示している。どちらの実装にも同じint8のテンソルを入力し、上位1件を選ぶ判定の扱いも揃えた。全範囲を網羅する1024通りの入力で判定が食い違った例はなく、実機でも同じチェックサムが3回とも一致した。ただしこれはモデル単体の測定で、マイクからの音声取り込みと特徴量の抽出は外してある。
開発者は制限も並べる。対応するのは量子化されたTFLiteの演算子の一部で、任意のモデルを変換できるわけではない。実機での測定は初代のESP32で行っており、S3では試していない。速度の改善もESP-NNに対して有用ではあるが劇的ではなく、現時点で効いているのはランタイムを外してフラッシュとRAMを減らした点だとしている。
リポジトリには変換元のモデル、生成器、生成済みのC++、回帰テスト、PlatformIOで動かすESP32のベンチマークが入る。生成器の動作にはPythonの標準ライブラリだけ、テストには通常のC++17コンパイラーがあれば足りる。呼び出し方も統一されていて、モデルを作って入力を渡せば結果が返る。分類器なら上位1件の番号が返り、出力の扱いを手で設定する必要はない。
次の目標に挙げるのは、モデルの重みとテンソルの形、静的に求めた活性化の範囲から、より安価な実装を自動で選ぶ仕組みだ。学習し直さずに済ませることを狙う。投稿では、次に対応すべき量子化モデルやESP32の系統について意見を求めている。